一直以来,要让机器人学会一项新任务,往往需要重新采集数据、编写固定流程,或进行针对性训练。9月24日,诺因(Knowin)发布面向通用具身智能的生成式学习架构GLOW技术报告,完整介绍了GLOW全新升级的整体技术架构,呈现了一条将通用认知能力转化为可靠物理行动的可行路径,核心突破在于实现了机器人“一教就会”的任务学习能力。
报告提出,GLOW将改变机器人学习新任务的方式:把人的一次完整操作、当前环境、机器人自身状态与执行历史放在同一条链路中理解,让机器人不只是看见动作画面,而是同时捕捉物体、空间关系、动作顺序和状态变化,从“看过”进一步走向“学会”,拥有跨物体、跨环境、跨任务复用的通用能力。
同时,报告还披露了GLOW的多项评测结果。从物理任务执行到具身场景理解,诺因已经连续拿下三项第一,印证了其长期坚持的自回归技术路线的前瞻性,以规模化物理经验训练模型,以统一架构协同认知与行动,以闭环执行适应环境变化,从而以完整的具身能力走向物理世界。
GLOW的目标,是让机器人获得跨物体、跨环境、跨任务复用的通用具身能力,而非为每项任务单独学习一套策略。用户不必把需求拆解成机器指令,也不必受限于出厂时写好的功能清单。机器人可以通过一次完整操作理解任务,再把画面、物品关系、状态变化与执行反馈转化为行动。从开盒收纳、浇水,到擦桌、调酒等各类家务工作,这一能力都得到了验证:
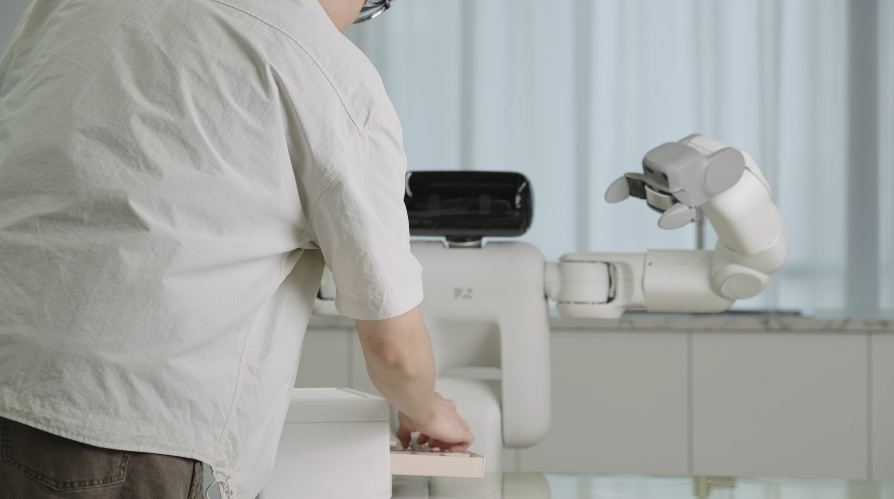
比如,开盒收纳包含开盖、放物、合盖三个核心步骤。GLOW会根据实时画面定位盒盖、物品和盒内区域,按照人类的操作逻辑完成整套动作。人类的操作只定义任务目标和操作顺序,实际执行时,机器人会根据现场的盒子大小、物品位置调整姿态和路径,即使更换了不同的盒子、不同的物品,机器人也能顺畅完成收纳,不用重新教学。
“一教就会”的背后,源于GLOW全新升级的技术路径。通过将原有的Brain与Act能力统一到多模态自回归模型KnowinGLOW中,让视觉理解、空间推理、任务规划与动作生成能够在同一模型内协同完成;KnowinDream负责生成物理交互经验,KnowinWorld用于模拟动作可能带来的结果,KnowinAgent则围绕任务记忆、工具调用、反馈和重新规划组织执行。由此,GLOW形成了从经验学习、任务理解到行动反馈的完整链路。
在RoboDojo的18项仿真任务中,GLOW取得62.2%的平均成功率和71.1分的平均得分,较GPT-6(Robocurve)基线分别高出40个百分点和41.3分。
通用模型拓展智能的知识、理解与推理能力,专业具身模型则以物理交互为核心,构建从场景理解到自主行动的完整能力。诺因持续推进这条技术路线:以规模化物理经验训练模型,以统一架构协同认知与行动,以闭环执行适应环境变化。
南方+记者 郜小平
冠达配资提示:文章来自网络,不代表本站观点。